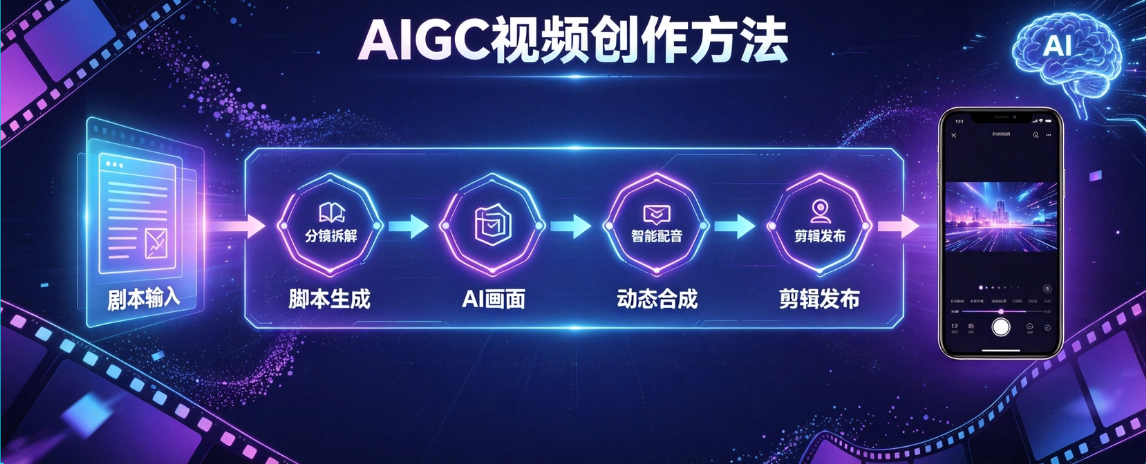
AIGC 视频创作现在不是“输入一句话等它自己出片”,而是脚本设计 → 分镜拆解 → 资产锁定 → 画面生成 → 动态化 → 配音配乐 → 剪辑合成 → 发布运营的流水线。零基础可以先跑通“即梦/可灵 + 剪映”的轻量链路,再逐步加入角色一致性、Agent 工作流和批量分发。
1. 先确定视频类型和产出目标
做之前先回答四个问题:
做什么类型:知识口播、短剧、漫剧、产品介绍、品牌片、数字人播报?
给谁看:抖音、视频号、小红书、B 站、公众号?
多长:短视频 15-60 秒,中视频 1-3 分钟,系列短剧可分集连载。
什么目标:引流、带货、涨粉、品牌宣传,还是做成可复用的内容资产?
短视频建议前 3 秒设置钩子,比如冲突、反差、提问、结果前置。
2. 用 AI 写结构化脚本
不要只让 AI 写一段文案,让它输出分镜表格。
提示词可以这样写:
请帮我写一个【类型】视频脚本,主题【主题】,受众【受众】,时长【时长】,风格【风格】。输出分镜表,包含:镜号、画面描述、人物动作、台词、时长、运镜方式。
脚本要口语化,避免长句。每个镜头建议 3-5 秒,整条短视频控制在 6-10 个镜头。
3. 拆解分镜
分镜表至少包含:
镜号
画面内容
人物动作/表情
台词
时长
运镜:推、拉、摇、移、固定、特写、全景
例如:
镜号 3:女主近景,站在窗边,眼神惊讶。台词:“你怎么会在这里?”时长 4 秒,镜头缓慢推近。
分镜越清楚,后面生成越稳定。
4. 锁定角色和画风
这是 AI 视频最容易翻车的地方。
建议先做角色资产:
正面、侧面、半身、全身
统一发型、服装、配饰
统一光影和画风
保存为角色基准图
后续每个镜头都引用同一组基准图,避免“变脸”。
提示词可以采用“锚定层 + 变量层”:
锚定层:发型、瞳色、肤色、服装、配饰等固定特征;
变量层:镜头角度、表情、动作、场景、光影。
例如:
“银黑短发、冰蓝瞳、冷白皮、黑色风衣、银链耳饰”是锚定层;“黄昏天台、近景、回头、风拂头发”是变量层。
5. 生成画面:先图后动更稳
推荐两条路径。
路径 A:文生视频,适合快速试水
直接把分镜描述输入视频模型,快速看效果。
路径 B:图生视频,更可控
先用即梦 AI、Midjourney、通义万相等生成关键帧,再让视频模型把它动起来。
新手更建议路径 B。因为静态图更容易检查角色、构图和画风,确认没问题后再做动态,返工成本更低。
6. 生成动态视频
单镜头建议控制在 3-10 秒,复杂动作可以再拆短。
常用工具分工:
即梦 AI:中文友好,剪映生态衔接好,适合短视频、营销素材、漫剧分镜。
可灵 AI:写实人物、动作镜头、长镜头表现较强,适合短剧和剧情类视频。
Runway:电影感、后期控制强,但中文适配和国内访问成本较高。
Vidu / 通义万相 / Pika:可按批量成本、风格化、开源部署需求选择。
注意不要一开始就追求 4K。先用低分辨率验证构图和动作,确认后再提升画质。
7. 配音、字幕和配乐
配音可以用剪映、豆包 TTS、ElevenLabs 等工具。
要点:
不同角色用不同音色;
语速建议接近自然说话;
BGM 音量低于人声,避免盖住台词;
字幕必须人工校对,尤其是人名、术语和数字;
如果模型支持原声口型同步,可以减少后期对齐成本。
8. 剪辑合成
剪映适合新手完成大部分工作:
按分镜拼接镜头;
对齐配音和字幕;
加转场、音效、BGM;
统一调色;
导出对应平台画幅,如 9:16 竖屏或 16:9 横屏。
如果做系列内容,建议保存模板:片头、片尾、字幕样式、字体、BGM、封面版式都复用,能明显提升效率。
9. 发布与复盘
发布前检查:
角色是否一致;
口型是否对齐;
字幕是否有错字;
开头 3 秒是否抓人;
结尾是否有引导;
是否按平台规则标注 AI 生成内容。
发布后重点看:
3 秒完播率;
整体完播率;
评论反馈;
收藏转发;
哪一集、哪一个镜头掉人最多。
这些数据会直接决定下一版脚本和分镜怎么改。
新手推荐工具组合
表格
目标 推荐组合 适合场景
零基础入门 豆包/DeepSeek + 即梦 AI + 剪映 口播、科普、短视频
短剧/漫剧 豆包 + 即梦/可灵 + 剪映 剧情连载、角色系列
数字人口播 大模型写稿 + 数字人工具 + 剪映 品牌讲解、知识号
进阶自动化 LangGraph/Dify + 可灵/即梦 API + 剪映 批量生产、矩阵分发
可以沉淀成智能体工作流
结合你现在的方向,比较适合做一个“AIGC 视频生产智能体”:
输入选题后,自动输出:
分镜脚本;
角色基准提示词;
画面提示词;
视频生成参数;
配音台词;
字幕文件;
标题、封面文案、话题标签。
这样你写技术文章、做安全/AI 内容时,可以同步把一篇文章拆成短视频、口播稿和多平台分发版本,内容生产效率和引流效果都会更稳。