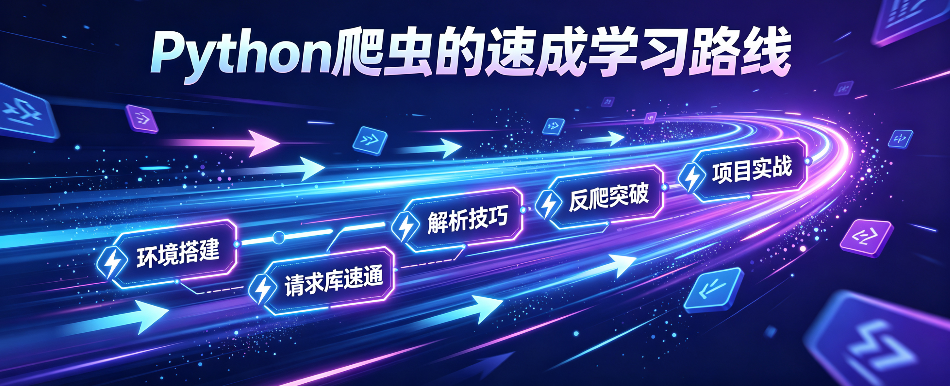
这份为你量身定制的 Python 爬虫速成学习路线,主打“以战养战、快速上手”。我们将学习过程分为四个阶段,按优先级排好,帮你避开枯燥的理论,直接切入核心实战:
一阶段:Python 极简基础(建议耗时:3-5天)
不要去看长篇大论的 Python 教程,只学爬虫用得上的语法:
核心数据结构:熟练掌握字符串(String)、列表(List)和字典(Dictionary)的增删改查。
控制流:for 循环(用来遍历网页数据)和 if-else 条件判断。
函数与异常:学会用 def 封装代码,必须掌握 try...except(网络请求极易出错,这是爬虫程序的“保命”语法)。
文件读写:学会把数据以 txt、csv 或 json 格式保存到本地。
二阶段:静态网页爬虫实战(建议耗时:1周)
这是爬虫的核心基本功,目标是抓取不需要登录、内容直接写在 HTML 里的网页。
认识网页:学会使用浏览器 F12(开发者工具),用“检查(Elements)”定位数据标签,用“网络(Network)”查看真实的请求接口。
发送请求:学习使用 requests 库发送 GET 请求,学会伪装 Headers(特别是 User-Agent)。
数据解析:学习 BeautifulSoup 或 lxml(XPath),从 HTML 中精准提取文字、图片链接。
实战练手:写一个“豆瓣电影 Top250 爬虫”或“名言警句爬虫”,完成“请求-解析-存入 CSV”的完整闭环。
三阶段:进阶与反爬虫对抗(建议耗时:1-2周)
当你发现代码报错、抓不到数据或 IP 被封时,就进入了这个阶段。
正则表达式(Regex):学习基础的正则语法,用于从杂乱文本中提取手机号、邮箱、特定格式的数据。
应对反爬机制:学习如何处理 Cookies 维持登录状态,如何使用代理 IP 池防止被封禁。
动态网页渲染:很多现代网站的数据是 JavaScript 加载的。学习使用 Selenium 或 Playwright 模拟真实浏览器操作(如自动滚动、点击按钮)。
实战练手:写一个“自动登录某论坛并抓取帖子”或“抓取需要翻页的动态加载列表”的爬虫。
四阶段:数据存储与工程化(进阶方向)
当你的数据量达到几万、几十万条时,就需要升级装备了。
数据库基础:学习基础的 SQL 语法,掌握轻量级数据库 SQLite 或关系型数据库 MySQL,将数据存入表中。
异步与并发:学习 asyncio 或 aiohttp,让你的爬虫从“单线程排队”变成“多线程并发”,抓取速度提升十倍。
爬虫框架:学习 Python 最强大的爬虫框架 Scrapy,掌握它的架构和中间件,能够写出企业级的爬虫项目。