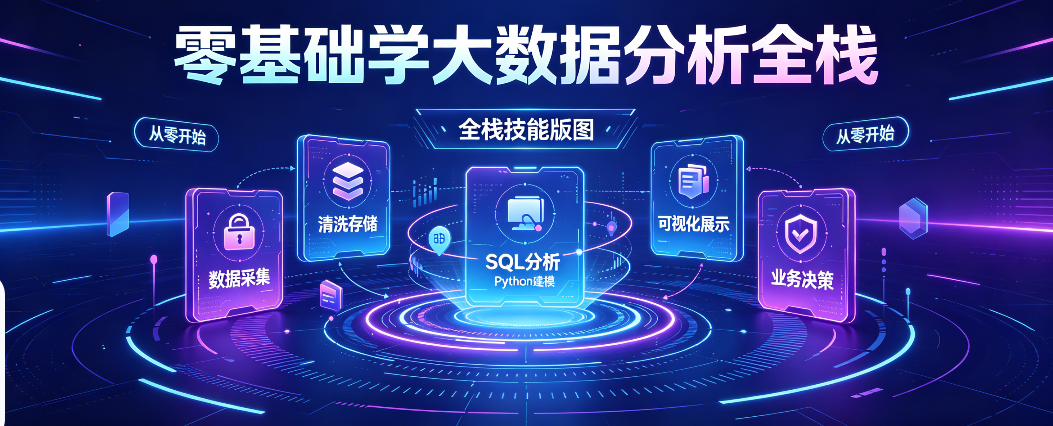
零基础想要学习“大数据分析全栈”,首先需要明确一个概念:在大数据领域,所谓的“全栈”通常指的是“技术小全栈”,即能够理解并动手操作数据从产生到产生价值的整个生命周期(从数据采集、存储、计算到应用)。
虽然技术栈庞大,但只要找对路径、循序渐进,零基础完全可以稳步进阶。以下为您梳理的一套科学、可落地的学习路线:
一:夯实前置基础(1-2个月)
大数据的所有框架都基于基础技术搭建,基础不牢,后续学习容易崩盘。
编程语言基础:推荐从 Python 入手,其语法简洁、生态丰富,是数据分析的主流。重点掌握数据类型、函数、文件操作等基础语法。同时,建议了解 Java 基础,因为大数据底层生态(如 Hadoop、Spark)多基于 Java/Scala 开发。
数据库与 SQL:SQL 是数据行业的“刚需技能”,日常工作中80%以上的分析需求都从 SQL 取数开始。必须熟练掌握增删改查、多表关联、聚合函数及窗口函数等。
操作系统与统计基础:学习 Linux 常用命令和 Shell 脚本,因为大数据集群几乎全部运行在 Linux 上。同时,补充描述统计、概率分布等统计学基础概念,这是读懂数据规律的底层逻辑。
二:掌握核心工具与框架(2-3个月)
这一阶段的目标是打通数据处理的完整链路,掌握主流的大数据技术栈。
数据处理与可视化:熟练使用 Python 的 Pandas、Numpy 库进行数据清洗与处理,掌握 Matplotlib 或 Seaborn 进行可视化。学习 Tableau 或 PowerBI 等 BI 工具,快速搭建交互式分析报表和仪表盘。
大数据底层与存储:了解 Hadoop 生态系统的核心组件,重点理解 HDFS 分布式存储和 MapReduce 计算框架的工作原理。
大数据计算引擎:学习 Hive(基于 Hadoop 的数据仓库工具)和 Spark(当前主流的分布式计算框架),掌握如何使用 SQL 操作 Spark 进行海量数据的批处理。
三:项目实战与进阶(长期坚持)
大数据是实践性极强的学科,看十遍教程不如自己动手做一个完整的项目。
全流程实战:结合行业场景(如电商、金融、互联网),完成从数据采集、清洗、分析到可视化报告的完整闭环项目。例如“电商用户流失原因探究”、“离线数仓分层建模”等。
前沿技术拓展:在掌握离线计算后,可以进一步学习 Flink 等实时流处理框架,掌握实时数据处理逻辑。此外,2026年的行业趋势也要求数据人才具备 AI 融合能力,如 Prompt 工程、RAG 知识库搭建等大模型应用落地技术。
零基础避坑指南
不要盲目追求“全栈”:大数据细分方向多,入门阶段不必追求掌握所有技术。建议先确定一个方向(如数据分析或大数据开发)深耕,再逐步拓展知识边界。
不要只学理论不练实战:切忌只背概念、不看代码。哪怕是复现别人的经典案例,也能在实操中加深理解、积累经验。
不要一上来就死磕源码:新手应优先掌握框架的部署、配置和使用,能独立做项目、会排障才是关键。底层源码优化是进阶内容,切勿本末倒置。
不要脱离业务学技术:所有技术都是为业务服务的。在学习过程中,要主动了解行业的业务指标和数据特点,理解场景才能吃透技术本质。