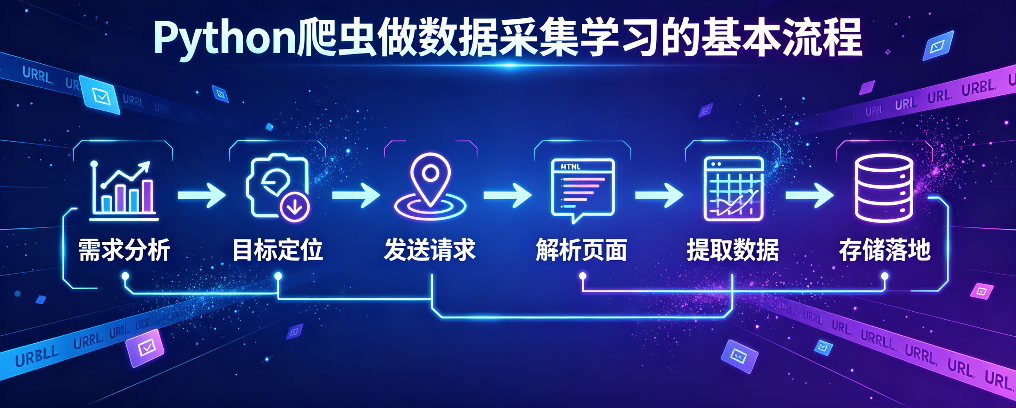
Python 爬虫做数据采集,本质上是一套从需求分析、请求构建、数据获取、解析处理到存储与维护的完整工程流程。结合零基础学习者的特点,这套流程可以拆解为以下五个核心步骤:
一:明确目标与合规审查(需求分析)
在动手写代码之前,首先要明确你要采集什么数据、数据用于什么目的,并评估合规风险。
业务目标:确定目标站点清单、需要抓取的字段结构(如商品价格、用户评论等)以及抓取策略(全站遍历还是增量更新)。
合规与红线:务必查阅目标网站的 robots.txt 协议,明确哪些数据允许爬取。遵守法律法规,绝不采集个人隐私数据或突破网站的反爬限制。
二:发送请求与获取数据(抓取网页)
这一步的核心是模拟浏览器向目标网站发送网络请求,获取网页的原始内容(如 HTML 源码或 JSON 数据)。
核心动作:通过代码向目标 URL 发送 GET 或 POST 请求,并携带必要的请求头(如 User-Agent)来伪装真实用户。
常用工具:新手 Python 的 requests 库,一行代码即可发送请求并获取响应数据。
三:解析与提取信息(筛选有用数据)
获取到的原始网页中通常包含大量广告、布局代码等无用信息,需要通过解析工具精准“淘金”。
核心动作:对响应数据进行处理,过滤无关信息,提取出你真正需要的文本、链接或图片地址。
常用工具:新手推荐使用 BeautifulSoup 库,它能快速解析网页源代码并提取指定内容;进阶可使用 lxml 结合 XPath 语法,或使用正则表达式处理复杂文本。
四:数据清洗与结构化处理
原始数据往往包含多余的空格、特殊符号或格式不统一,直接存储会影响后续分析。
核心动作:对提取出的数据进行去重、去除空值、类型转换(如将字符串转为数字)等操作,将其转化为规范的结构化数据。
常用工具:使用 Python 强大的数据处理库 Pandas,可以轻松完成数据清洗、转换和重塑工作。
五:数据存储与自动化控制
将清洗后的有用信息持久化保存,并实现批量或定时采集。
核心动作:将数据保存到本地文件或数据库中,并通过循环、分页等技术实现批量抓取。
常用工具:小规模数据可保存为 CSV、JSON 或 Excel 表格;大规模数据则推荐存入 MySQL 或 MongoDB 数据库。后续还可结合定时任务实现自动化采集。
掌握了这五个基本流程,你就具备了数据采集的完整思维框架。接下来,你想先从哪一步开始实操?我可以为你提供一个简单的静态网页采集案例,带你跑通整个流程。